Resumen ejecutivo
- Cliente
- KS Promocionales
- Resultado técnico documentado
- 2.096 páginas de producto generadas; 2.008 elegibles para indexación según la configuración del proyecto.
- Las cifras describen la configuración del proyecto (páginas generadas y elegibles), no la indexación efectiva en buscadores ni resultados comerciales.
El problema
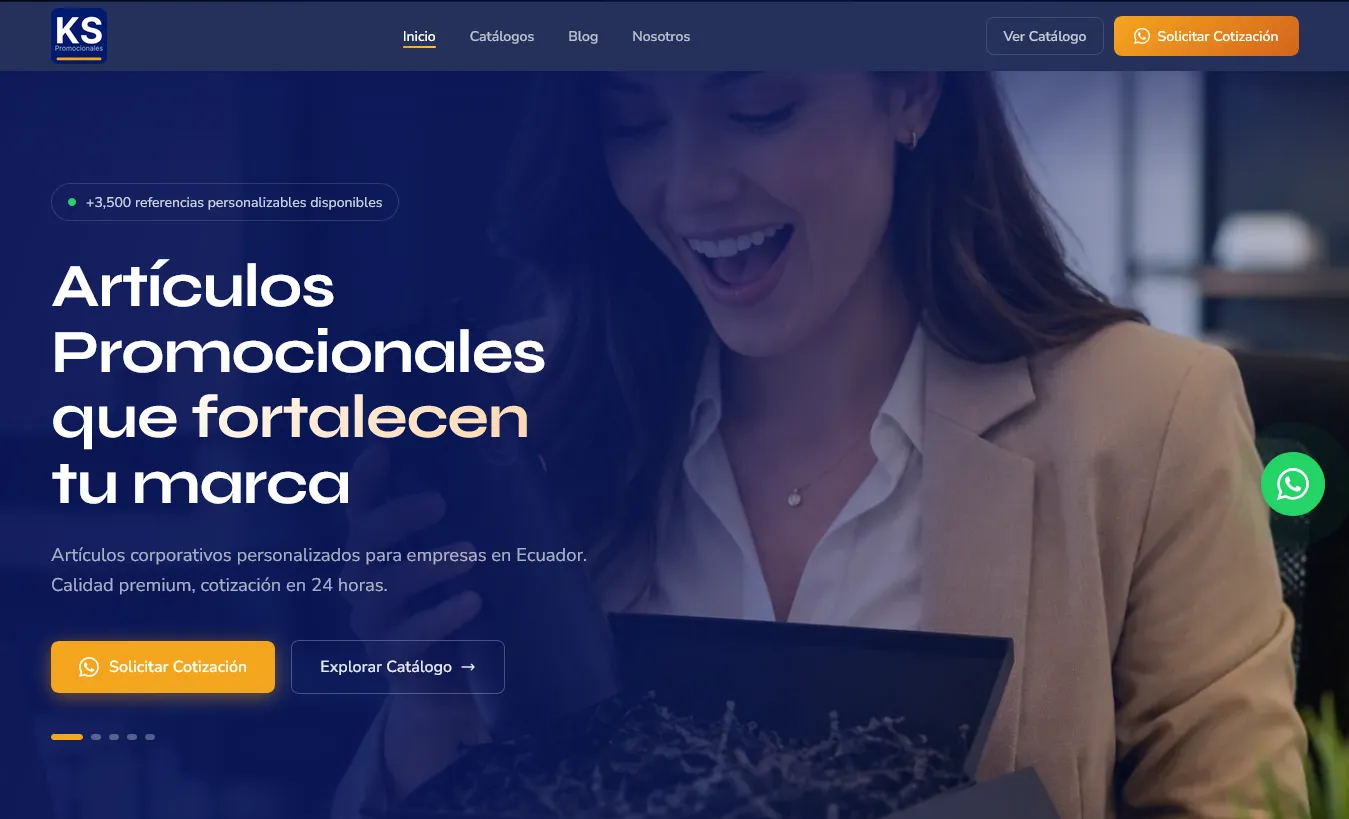
El catálogo del proveedor estaba disperso y no tenía una presencia digital escalable: mantener a mano una ficha útil para cada producto no era viable con miles de referencias.
La solución
Un pipeline separa la extracción de datos, el enriquecimiento de contenido y la publicación. El sitio se genera en build-time a partir de una base de datos Postgres serverless y se despliega en CDN sin servidor en runtime.
Alcance técnico
- Scraper del catálogo del proveedor
- Modelo de datos en Postgres serverless (Neon)
- Enriquecimiento de fichas con Claude Haiku
- Sitio estático con Next.js 14
- Despliegue continuo y cabeceras de seguridad en Netlify
Decisiones técnicas
Desacoplar extracción y despliegue
Los productos se guardan primero en Postgres. Un fallo del scraper no rompe el sitio publicado y el build trabaja siempre sobre datos ya validados.
Controlar la calidad antes de indexar
Solo las fichas marcadas como enriquecidas son elegibles para indexación; las demás reciben noindex para no publicar contenido delgado.
Reducir el peso que llega al navegador
El catálogo se divide en archivos JSON ligeros por categoría en lugar de un único archivo de 469 KB cargado en cliente.
Qué se entregó
- 2.096 páginas de producto y 34 categorías generadas de forma estática
- Variantes duplicadas resueltas con canonical y noindex
- Redirecciones 301 declarativas para cambios de URL
- Cabeceras HSTS, CSP y X-Frame-Options configuradas en la CDN
Cómo funciona, paso a paso
- 01 Un scraper en Python recorre el catálogo del proveedor y extrae nombres, descripciones, imágenes y categorías.
- 02 Los productos se almacenan en Neon (Postgres serverless), separando la extracción del despliegue.
- 03 Un script de sincronización envía lotes de 5 productos a Claude Haiku para generar títulos, descripciones, características y casos de uso.
- 04 Solo los productos marcados como optimizados (2.008) son elegibles para indexación; los 88 restantes reciben noindex.
- 05 Un paso de prebuild divide el catálogo en JSON ligeros por categoría (6 campos, máximo 80 ítems).
- 06 Next.js genera el export estático: 2.096 páginas de producto, 34 categorías, blog y landing pages.
- 07 Cada commit dispara un rebuild automático en Netlify.
Stack tecnológico
- Next.js 14
- Generación estática del sitio
- Neon (Postgres)
- Base de datos serverless
- Claude Haiku
- Enriquecimiento de fichas de producto
- Python 3
- Extracción del catálogo del proveedor
- Netlify
- CDN, CI/CD y cabeceras de seguridad
- next-sitemap
- Sitemap XML