Automatización e integración de datos

Automatización de catálogos e integración de datos

Pipelines que extraen, validan y sincronizan datos entre sistemas —catálogos de proveedores, fuentes públicas y bases de datos— con procesos programados, APIs y paneles de consulta.

¿Cuándo conviene?

Encaja si…

  • Equipos que copian datos a mano entre sistemas, hojas de cálculo y sitios web
  • Empresas que dependen de datos de proveedores o fuentes públicas que cambian con frecuencia
  • Responsables que necesitan consultar información consolidada sin pedir informes manuales

No es el servicio adecuado para…

  • Proyectos de ciencia de datos o modelos predictivos a medida
  • Extracción de datos que vulnere los términos de uso de la fuente

Escenarios habituales

Datos de proveedor siempre actualizados

Un proceso programado extrae los datos, los valida y actualiza tu catálogo o tu base de datos, con reintentos y registro de errores.

Consolidar fuentes dispersas

Varias fuentes con formatos distintos se normalizan en un modelo común y se exponen mediante una API o un panel.

Enriquecer información a escala

Se generan o completan descripciones y atributos con IA dentro de un flujo con controles de calidad antes de publicar.

Alcance

Incluido

  • Inventario de fuentes, formatos y reglas de negocio
  • Pipeline de extracción, validación y carga (ETL) programado
  • Registro de errores y rechazos para auditoría
  • API o panel de consulta según la necesidad
  • Documentación de operación y de re-ejecución

Fuera de alcance

  • Licencias de software de terceros
  • Operación 24/7 sin un acuerdo de soporte específico

Qué necesitamos de tu equipo

  • Accesos o credenciales de las fuentes y destinos
  • Ejemplos de datos reales y casos límite
  • Definición de quién revisa los errores que reporta el sistema

Entregables

Mapa de datos
Fuentes, transformaciones, destinos y reglas de validación documentados.
Pipeline en ejecución
Proceso programado con reintentos, idempotencia y registro de errores.
API o panel
Acceso a los datos consolidados con filtros acordados.
Guía de operación
Cómo ejecutar, reprocesar y diagnosticar el sistema.

Puntos de revisión contigo

  1. 01

    Descubrimiento

    Resumen del problema y objetivos · Alcance inicial con supuestos · Riesgos y dependencias identificados

  2. 02

    Diseño UX/UI

    Mapa del sitio o del flujo de datos · Prototipo navegable de las plantillas clave · Criterios de aceptación por tarea

  3. 03

    Desarrollo

    Acceso a una versión de prueba · Código versionado en tu repositorio · Registro de decisiones técnicas

  4. 04

    Validación

    Checklist de verificación con resultados · Lista de incidencias abiertas, si las hay

  5. 05

    Entrega

    Sistema en producción · Accesos y documentación · Plan de mantenimiento propuesto

Cómo trabajamos en detalle

Criterios de calidad

  • Cargas idempotentes: re-ejecutar no duplica datos
  • Ningún registro inválido se descarta sin dejar rastro
  • Credenciales fuera del código y del repositorio
  • Alertas o registros revisables cuando una ejecución falla

Casos relacionados

Datos abiertos · Sector público (Colombia)

ContrataData

Contratación pública consolidada en una API y un panel analítico
Reto
Los datos de contratación pública estaban repartidos entre fuentes con formatos heterogéneos y no había una forma unificada de consultarlos y analizarlos.
Resultado técnico
Pipeline incremental e idempotente con registro de rechazos, API documentada y panel con filtros combinables.
  • Automatización e integración de datos

Comercio electrónico · Productos promocionales (Ecuador)

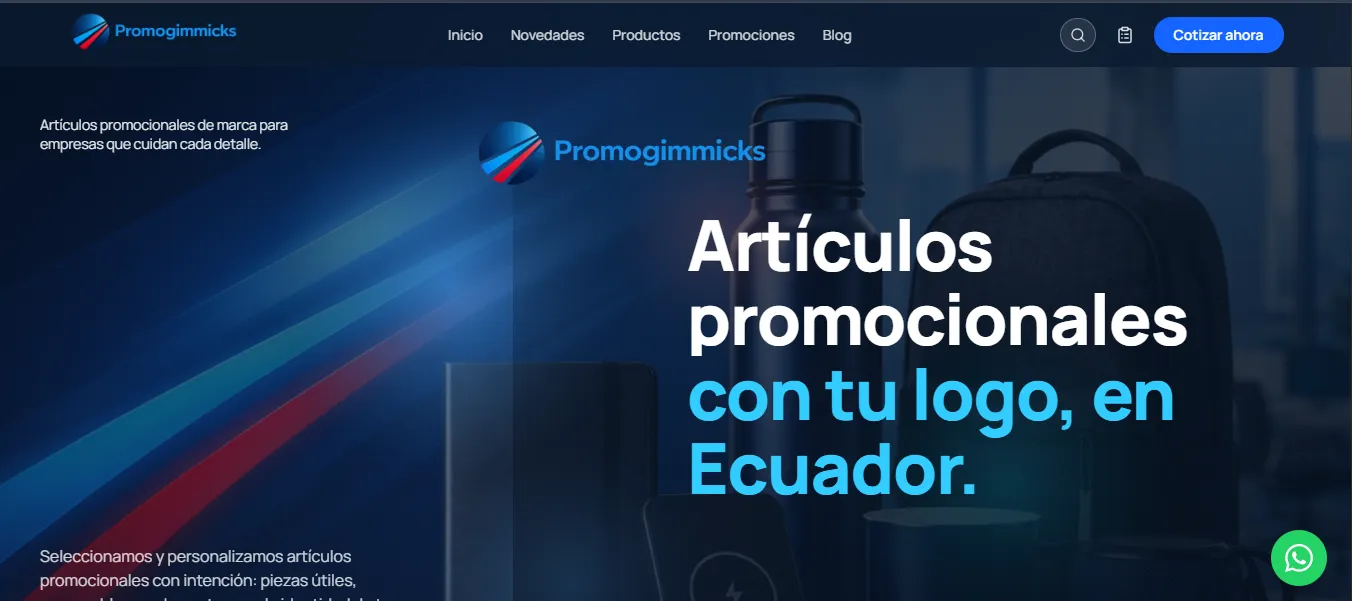
PromoGimmicks

Un catálogo de e-commerce que se actualiza a diario sin pasos manuales
Reto
Las fichas debían reflejar a diario los datos del proveedor (precios, imágenes, categorías). Actualizarlas a mano era lento y propenso a errores.
Resultado técnico
Más de 1.000 páginas de producto regeneradas por un flujo diario programado, sin pasos manuales en la publicación.
  • Automatización e integración de datos
  • Productos web B2B

Comercio B2B · Productos promocionales (Ecuador)

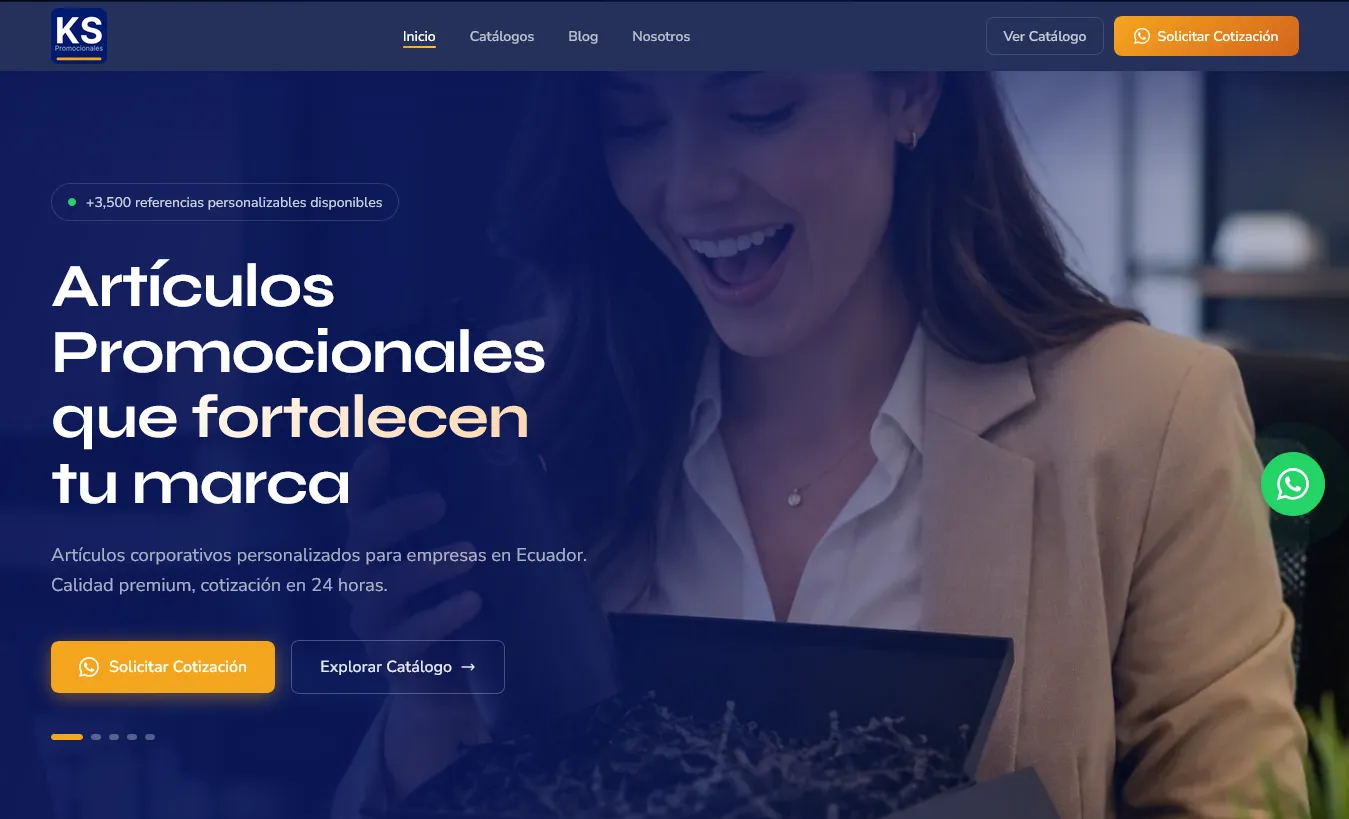
KS Promocionales

Un catálogo B2B automatizado con generación estática de páginas

Reto
El catálogo del proveedor estaba disperso y no tenía una presencia digital escalable: mantener a mano una ficha útil para cada producto no era viable con miles de referencias.
Resultado técnico
2.096 páginas de producto generadas; 2.008 elegibles para indexación según la configuración del proyecto.
  • Productos web B2B
  • Automatización e integración de datos

Preguntas frecuentes

¿Qué pasa si la fuente de datos cambia?

Las validaciones detectan cambios de formato y registran los registros afectados. El mantenimiento posterior se acuerda según la frecuencia de cambios esperada.

¿Qué fuentes de datos se han automatizado en los casos publicados?

Catálogos web de proveedores (extracción con Python), la API pública Socrata de datos.gov.co y bases de datos PostgreSQL. Otras fuentes se evalúan en el descubrimiento según su formato y condiciones de uso.

¿Dónde se ejecutan los procesos?

En la infraestructura que mejor encaje con tu operación: GitHub Actions, un servidor propio o servicios gestionados. Se decide en la fase de descubrimiento.

¿Se puede usar IA para completar datos?

Sí, como un paso más del flujo y con controles: qué se genera, con qué fuente y qué se revisa antes de publicar.

¿Qué necesita resolver tu equipo?

Describe el reto en unas líneas. Con esa información se propone una conversación para revisarlo y definir el siguiente paso.